
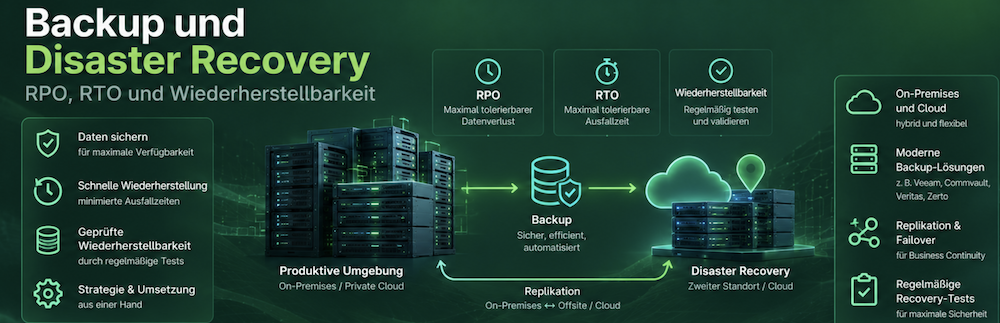
Backup und Disaster Recovery: Schutz, Wiederherstellung und belastbare Recovery-Ziele
Backup und Disaster Recovery verfolgen unterschiedliche, aber zusammenhängende Ziele. Ein Backup stellt wiederherstellbare Datenstände bereit; ein Disaster-Recovery-Konzept beschreibt zusätzlich, wie Anwendungen, Infrastruktur und Betriebsabläufe nach einem größeren Ausfall wieder funktionsfähig werden.
RPO, RTO und MTD zuerst definieren
Technische Produkte sollten erst nach den fachlichen Recovery-Zielen ausgewählt werden. Das Recovery Point Objective (RPO) legt fest, auf welchen Datenstand nach einer Störung zurückgekehrt werden muss; daraus ergibt sich der tolerierbare zeitliche Datenverlust. Das Recovery Time Objective (RTO) begrenzt die für die technische Wiederherstellung vorgesehene Zeit. Davon zu unterscheiden ist die Maximum Tolerable Downtime (MTD), also die maximal tolerierbare Unterbrechung des Geschäftsprozesses. NIST behandelt diese Ziele im Rahmen der Business-Impact-Analyse; technische Wiederherstellung und anschließender Wiederanlauf müssen zum geschäftlichen Zeitrahmen passen.
Mehrere Kopien und getrennte Fehlerdomänen
Veeam beschreibt die 3-2-1-Regel als grundlegendes Modell: mindestens drei Datenkopien, auf mindestens zwei unterschiedlichen Medientypen, davon mindestens eine Kopie außerhalb des primären Standorts. Moderne Konzepte ergänzen dies häufig um unveränderliche oder logisch getrennte Kopien.
Die Existenz eines Backups ist jedoch kein Nachweis der Wiederherstellbarkeit. Restore-Prozesse müssen regelmäßig getestet werden. Dazu gehören je nach Anwendung auch Abhängigkeiten, Startreihenfolgen, Identitäten, Netzwerke, Datenbanken und externe Dienste.
Snapshots sind nicht automatisch Backups
Ein VMware-VM-Snapshot ist primär ein kurzfristiger Zustandsmechanismus und ersetzt kein unabhängiges Backup. Er verbleibt typischerweise in derselben Storage- und Administrationsfehlerdomäne wie die VM. Array-Snapshots können andere Eigenschaften besitzen und Teil eines Schutzkonzepts sein, müssen aber hinsichtlich Fehlerdomäne, Replikation, Aufbewahrung und unabhängiger Wiederherstellbarkeit separat bewertet werden.
Disaster Recovery ist ein Betriebsprozess
NIST SP 800-34 Rev. 1 ordnet Disaster Recovery in einen umfassenderen Contingency-Planning-Prozess ein. Dazu gehören Business Impact Analysis, präventive Kontrollen, Recovery-Strategien, dokumentierte Pläne, Tests und laufende Pflege. Ein DR-Plan ist deshalb nur dann belastbar, wenn Verantwortlichkeiten, Entscheidungswege und technische Runbooks aktuell gehalten und geübt werden.
Quellen und Prüfstand
Quellenabgleich: 9. Oktober 2026. Grundlage sind die NIST-Begriffe und der Notfallplanungsleitfaden sowie die jeweils angegebenen Herstellerdokumentationen.
- NIST: SP 800-34 Rev. 1: Notfallplanung für Informationssysteme – veröffentlicht im Mai 2010, aktualisiert am 11. November 2010.
- NIST-Glossar: RPO, RTO und MTD – Datenstand, technische Wiederherstellung und tolerierbare Prozessunterbrechung.
- Veeam: Backup Copy und die 3-2-1-Regel – die gelesene Seite weist Build 13.1.1.18 als Geltungsbereich aus; Seitenänderungsdatum 17. März 2025.
- VMware by Broadcom: KB 318825: Umgang mit VMware-Snapshots – dokumentierter Geltungsbereich vSphere/ESXi 8.x, ESX 9.x und vCenter 8.x/9.x; abgerufen am 9. Oktober 2026.
Die Prüfung betrifft die publizierten Begriffe und Architekturhinweise. Ein Wiederherstellungstest oder Nachweis der RPO-/RTO-Erfüllung in einer Kundenumgebung wurde nicht durchgeführt.
Weiterführende Themen
Unsere Leistungen: Storage, Backup und Disaster Recovery. Ergänzende Artikel behandeln Storage-Architektur und VCF-Lifecycle und Migration.