
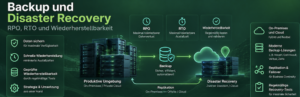
Backup und Disaster Recovery: Schutz, Wiederherstellung und belastbare Recovery-Ziele
Backup und Disaster Recovery verfolgen unterschiedliche, aber zusammenhängende Ziele. Ein Backup stellt wiederherstellbare Datenstände bereit; ein Disaster-Recovery-Konzept beschreibt zusätzlich, wie Anwendungen, Infrastruktur und Betriebsabläufe nach einem größeren Ausfall wieder funktionsfähig werden.
RPO, RTO und MTD zuerst definieren
Technische Produkte sollten erst nach den fachlichen Recovery-Zielen ausgewählt werden. Das Recovery Point Objective (RPO) beschreibt den maximal tolerierbaren Datenverlust in Zeit, das Recovery Time Objective (RTO) die angestrebte Wiederherstellungsdauer. NIST ordnet darüber hinaus die Maximum Tolerable Downtime (MTD) in die Business-Impact-Analyse ein. Diese Werte müssen servicebezogen festgelegt werden.
Mehrere Kopien und getrennte Fehlerdomänen
Veeam beschreibt die 3-2-1-Regel als grundlegendes Modell: mindestens drei Datenkopien, auf mindestens zwei unterschiedlichen Medientypen, davon mindestens eine Kopie außerhalb des primären Standorts. Moderne Konzepte ergänzen dies häufig um unveränderliche oder logisch getrennte Kopien.
Die Existenz eines Backups ist jedoch kein Nachweis der Wiederherstellbarkeit. Restore-Prozesse müssen regelmäßig getestet werden. Dazu gehören je nach Anwendung auch Abhängigkeiten, Startreihenfolgen, Identitäten, Netzwerke, Datenbanken und externe Dienste.
Snapshots sind nicht automatisch Backups
Ein VMware-VM-Snapshot ist primär ein kurzfristiger Zustandsmechanismus und ersetzt kein unabhängiges Backup. Er verbleibt typischerweise in derselben Storage- und Administrationsfehlerdomäne wie die VM. Array-Snapshots können andere Eigenschaften besitzen und Teil eines Schutzkonzepts sein, müssen aber hinsichtlich Fehlerdomäne, Replikation, Aufbewahrung und unabhängiger Wiederherstellbarkeit separat bewertet werden.
Disaster Recovery ist ein Betriebsprozess
NIST SP 800-34 Rev. 1 ordnet Disaster Recovery in einen umfassenderen Contingency-Planning-Prozess ein. Dazu gehören Business Impact Analysis, präventive Kontrollen, Recovery-Strategien, dokumentierte Pläne, Tests und laufende Pflege. Ein DR-Plan ist deshalb nur dann belastbar, wenn Verantwortlichkeiten, Entscheidungswege und technische Runbooks aktuell gehalten und geübt werden.
Neueste Beiträge
- Infrastructure Automation: APIs, Self-Service und GitOps in der Private Cloud
- Omnissa Horizon 8: VDI, Remote Apps und vGPU richtig planen
- VMware Cloud Foundation 9.1: Architektur, Lifecycle und Migration
- RAG und Private AI: Unternehmenswissen kontrolliert für KI nutzen
- Storage für VMware: vSAN, SAN, Fibre Channel und externe Arrays
Schreibe einen Kommentar
Du musst angemeldet sein, um einen Kommentar abzugeben.