
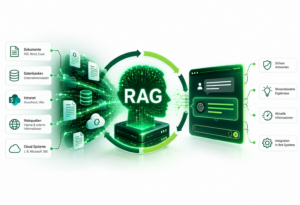
Retrieval-Augmented Generation: Unternehmenswissen kontrolliert für KI nutzbar machen
Retrieval-Augmented Generation (RAG) verbindet ein generatives Sprachmodell mit extern bereitgestelltem Wissen. Statt sich ausschließlich auf im Modell gespeicherte Informationen zu verlassen, werden zur Laufzeit passende Dokumente oder Textabschnitte gesucht und als zusätzlicher Kontext an das Modell übergeben. Das Grundprinzip wurde 2020 von Lewis et al. beschrieben und kombiniert parametrisches Modellwissen mit einer nichtparametrischen Wissensquelle.
Für Unternehmen ist dieser Ansatz interessant, wenn interne Dokumente, technische Handbücher, Betriebsinformationen oder andere kontrollierte Datenbestände für KI-gestützte Suche und Assistenz nutzbar gemacht werden sollen. Eine produktive Architektur benötigt jedoch deutlich mehr als ein Sprachmodell und eine Vektordatenbank.
Wie eine RAG-Pipeline funktioniert
Eine typische Pipeline erfasst Dokumente, zerlegt sie in geeignete Segmente, erzeugt Vektorrepräsentationen und speichert diese in einem Suchindex. Bei einer Anfrage wird die Suchfrage ebenfalls eingebettet; relevante Segmente werden ermittelt und können durch einen Reranker neu bewertet werden. Erst danach erhält das Sprachmodell die Benutzerfrage zusammen mit dem ausgewählten Kontext.
Qualität hängt unter anderem von Dokumentqualität, Chunking, Retrieval-Verfahren, Top-k-Auswahl, Reranking, Prompting und Modellwahl ab. Die RAGAs-Arbeit von Es et al. trennt deshalb Evaluationsdimensionen wie Kontextrelevanz, quellentreue Nutzung des Kontextes und Qualität der generierten Antwort.
Kontextfenster sind kein Ersatz für gutes Retrieval
Mehr Kontext führt nicht automatisch zu besseren Antworten. Liu et al. zeigen in „Lost in the Middle“, dass die Nutzung langer Kontexte in den untersuchten Modellen und Aufgaben positionsabhängig sein kann. Daraus folgt keine pauschale Grenze für alle heutigen Modelle, wohl aber eine wichtige Designregel: relevante Informationen sollten gezielt ausgewählt und die tatsächliche Antwortqualität mit repräsentativen Unternehmensfragen überprüft werden.
Berechtigungen und indirekte Prompt Injection
RAG kann die Nachvollziehbarkeit verbessern, beseitigt Sicherheitsrisiken aber nicht automatisch. Abgerufene Dokumente können beispielsweise Anweisungen enthalten, die das Modell beeinflussen. Greshake et al. beschreiben dieses Risiko als indirekte Prompt Injection. Deshalb sollten Retrieval, Berechtigungen, Datenklassifizierung und gegebenenfalls nachgelagerte Aktionen getrennt kontrolliert werden.
Ein Benutzer darf über die Retrieval-Schicht nur Informationen erhalten, für die er tatsächlich berechtigt ist. Besonders bei gemeinsam genutzten Indizes oder mehreren Datenräumen müssen Identität und Zugriffsrechte in das Design einbezogen werden.
Private AI und Datenhoheit
Für sensible Unternehmensdaten kann RAG als Bestandteil einer Private-AI-Architektur vollständig oder teilweise im eigenen Rechenzentrum betrieben werden. On-Premises bedeutet dabei nicht automatisch „sicher“. Die Sicherheitswirkung entsteht aus der konkreten Architektur, aus Identitäts- und Berechtigungskonzepten, Verschlüsselung, Protokollierung, Modell- und Index-Lifecycle sowie dem Betrieb.
NVIDIA beschreibt in seinen Enterprise-RAG-Referenzen Embedding, Retrieval, Reranking und LLM als getrennt skalierbare Dienste. Diese Dokumentation ist eine technische Referenz und kein Nachweis dafür, dass dch iT GmbH genau dieses Produkt einsetzt.
dch iT GmbH arbeitet nach eigener Angabe mit einem einsatzbereiten RAG-System und als Private AI TAP Partner. Diese Angaben beschreiben den bestätigten Unternehmensstand; daraus werden keine zusätzlichen Zertifizierungen, Herstellerzuordnungen oder Leistungswerte abgeleitet.
Neueste Beiträge
- Infrastructure Automation: APIs, Self-Service und GitOps in der Private Cloud
- Omnissa Horizon 8: VDI, Remote Apps und vGPU richtig planen
- VMware Cloud Foundation 9.1: Architektur, Lifecycle und Migration
- RAG und Private AI: Unternehmenswissen kontrolliert für KI nutzen
- Storage für VMware: vSAN, SAN, Fibre Channel und externe Arrays
Schreibe einen Kommentar
Du musst angemeldet sein, um einen Kommentar abzugeben.